02 / 07GRADUATION PROJECT · TEAM OF 4
NOTERA AI
把上課、影片與圖片的資訊,用 AI 整理成好讀的筆記。
01
IDEA
一開始,只有一個方向。
如果上課、影片、圖片裡的資訊,能讓 AI 整理成好讀的筆記。
真正開始做才發現,難的不是「叫 AI 摘要」,而是哪些內容要留下、圖片怎麼理解、程式碼怎麼保留,以及團隊要怎麼在時間內做完。
發想的流程
VIDEO / IMAGE / SLIDE → AI → NOTE- 01
Video / Image / Slide
影片、圖片、投影片
- 02
AI
AI 讀取
- 03
Note
好讀的筆記
三個要素
01VIDEO / IMAGE / SLIDE
影片、圖片、投影片
把上課用到的素材直接帶進來。
02AI
AI 讀取
文字與畫面一起讀,整理內容。
03NOTE
好讀的筆記
整理成結構化的筆記。
章節結論方向只有一個,難的是決定裡面要放什麼。NOTERA / 01 · IDEA
02
SCOPE
想做的很多,所以要先選。
分成 WANT / MUST / LATER,先把有限時間內做得完的範圍定下來。
不可能全做;所以先分清哪些留下、哪些之後再說。
範圍表
WANT / MUST / LATER| WANT想要 |
|
|---|---|
| MUST必備 |
|
| LATER之後再說 |
|
範圍的決定方式
WANT / MUST / LATER01WANT
想做的事
最初較寬的方向,從這裡開始收斂範圍。
02MUST
在時間內完成的條件
圖片/影片處理、結構化筆記、多語言與程式內容,以及 Demo。
03LATER
現在不做的事
先放在範圍外的三項,之後再回來。
章節結論不是功能越多越好,而是要先讓主要流程真的跑完。NOTERA / 02 · SCOPE
03
TEAM
四個人的畢業專題,我以組長身分整理方向並參與開發。
我擔任組長,負責整理題目方向與整體架構,也完成自己負責的實作;組員協助資料整理、報告撰寫與發表。
不需要一開始就每個人做一樣的事;先把要做什麼、做到哪裡說清楚。
團隊分工
四人畢業專題我負責的部分(組長)
- 01IDEA題目提出
- 02ARCHITECTURE整體架構
- 03INTEGRATION整合判斷
組員負責的部分
- 01DOCUMENT整理資料
- 02TEST交付確認
- 03PRESENTATIONPPT 與發表
分工明細
開發與資料分工01我負責的部分(組長)
IDEA / 題目提出
提出問題,整理主要構想。
02我負責的部分(組長)
ARCHITECTURE / 整體架構
決定設計與開發方向。
03我負責的部分(組長)
INTEGRATION / 整合判斷
對齊銜接點,做最後判斷。
04組員負責的部分
DOCUMENT / 整理資料
整理資料並完成報告。
05組員負責的部分
TEST / 交付確認
協助確認交付內容。
06組員負責的部分
PRESENTATION / PPT 與發表
製作 PPT 與發表資料。
章節結論我的工作不是把所有東西一個人做完,而是先把題目與架構定清楚,再讓四個人的工作能往同一個成果靠攏。NOTERA / 03 · TEAM
04
PLAN
先切到能在時間內完成的大小。
我們不是一開始就各自寫自己的部分,而是先確認資料怎麼進來、怎麼被處理、最後要怎麼讓使用者看到結果。
進行的分段
RESEARCH → UI → CORE → DOCS → PRESENTATION01RESEARCH
確認資料的入口。
02UI
實作呈現方式。
03CORE
把整體接起來。
04DOCS
整理資料與報告。
05PRESENTATION
整理 PPT 與發表資料。
先定下的三件事
IN / PROCESS / VIEW01IN
資料怎麼進來
先決定輸入的形狀。
02PROCESS
怎麼被處理
讀取與整理的流程。
03VIEW
最後怎麼被看到
連筆記畫面一起想。
章節結論先把順序定下來,有限的時間裡也能往前走。NOTERA / 04 · PLAN
05
BUILD
從輸入到筆記的流程。
做出來的是一條 INPUT → UNDERSTAND → ORGANIZE → OUTPUT 的流程。
比起列出技術名稱,更想把銜接點做成看得見的形狀。
建置的流程
INPUT → UNDERSTAND → ORGANIZE → OUTPUT- 01
INPUT
影片/圖片輸入
- 02
UNDERSTAND
文字與畫面辨識
- 03
ORGANIZE
重點整理與去重
- 04
OUTPUT
結構化筆記
Vue 3 / FastAPI / Local AI / Docker
四個階段
01INPUT
影片/圖片輸入
直接讀入影片與圖片。
02UNDERSTAND
文字與畫面辨識
用 OCR 與 VLM(視覺語言模型),把文字和畫面一起讀。
03ORGANIZE
重點整理與去重
選出要留下的內容。
04OUTPUT
結構化筆記
整理成好讀的形式。
章節結論看得見銜接點,也就知道哪裡卡住。NOTERA / 05 · BUILD
06
DECISIONS
改用 VLM 讀取,輸入縮減為投影片。
最有價值的不是最後用了什麼,而是中途怎麼改。
改掉讀取的核心,也收窄了材料;兩個調整都是為了在有限時間裡守住主要流程。
兩個轉折OCR 優先 → VLM-First
音訊+投影片 → 只用投影片
判斷 01
OCR 優先 → VLM-First原本
- OCR
- 語言/文字判定
- 筆記
調整後
- 畫面與 OCR 文字
- VLM 分析
- 筆記
程式碼、英文與混合語言的內容容易誤判被濾掉。
判斷 01 的理由
OCR 優先 → VLM-First01
問題是什麼
程式碼、英文與混合語言容易缺漏。
02
怎麼改
用 VLM 分析 Screenshot + OCR,把文字與畫面一起讀。
判斷 02
音訊+投影片 → 只用投影片原本
- 音訊+投影片
- 判斷
調整後
- 投影片
- 輸出
收音不好,效果不行。
判斷 02 的理由
音訊+投影片 → 只用投影片01
問題是什麼
原本想同時用音訊與投影片判斷,但音訊的狀態不好。
02
怎麼改
改成只用投影片輸出。
章節結論決定先讓主要流程跑起來,是這次最重要的判斷。NOTERA / 06 · DECISIONS
07
RESULT
用實際 Demo 收尾。
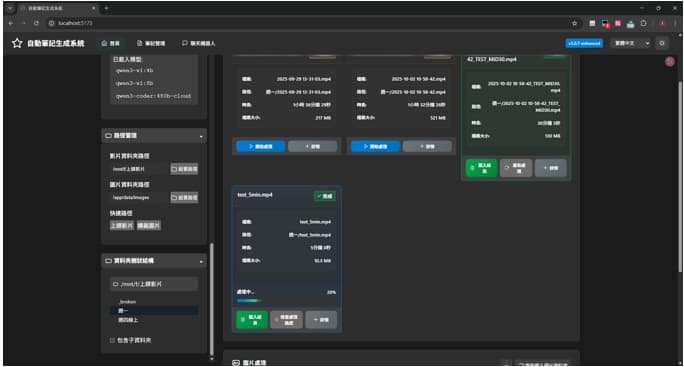
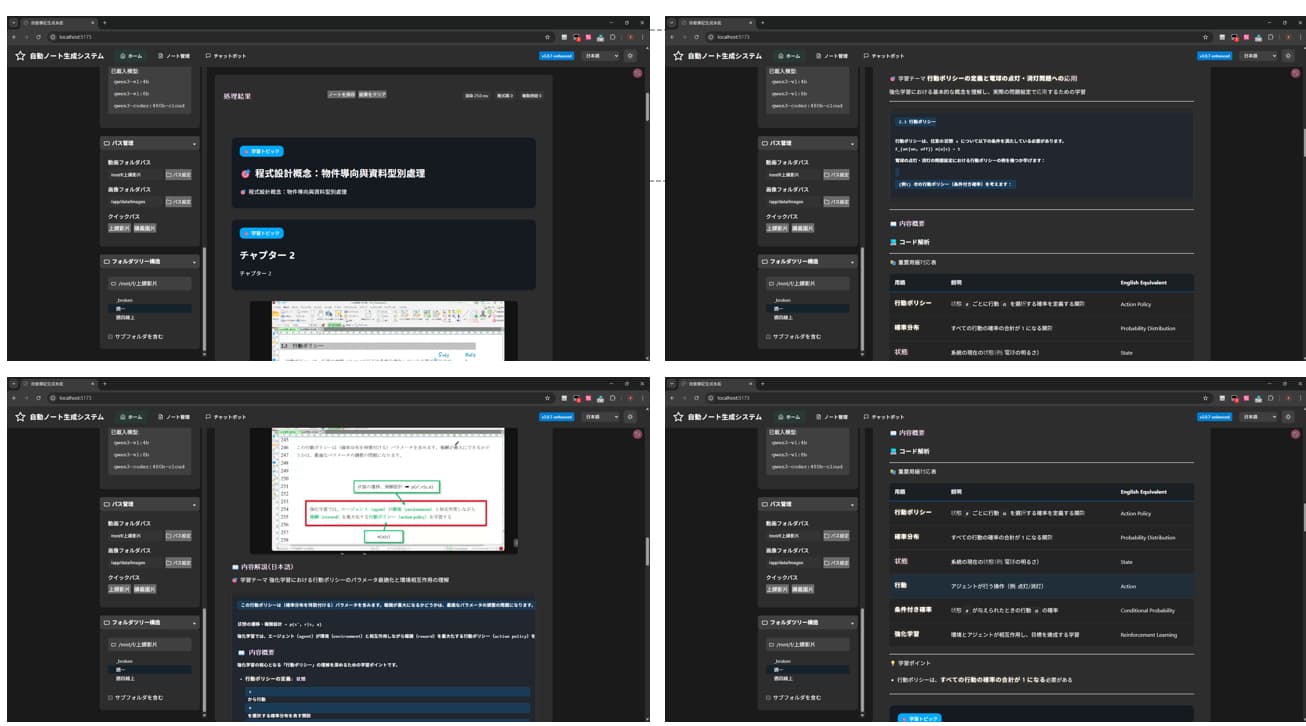
從影片輸入、處理狀態到筆記結果,用實際畫面把流程說清楚。
畢業專題已完成發表,也做出了能實際 Demo 的版本。用 Ollama 在本機跑 qwen3-vl:4b,搭配 PaddleOCR-VL 處理素材:短片能跑完,長片則受本機算力限制。
Demo 記錄
INPUT / VIDEO LIST / NOTE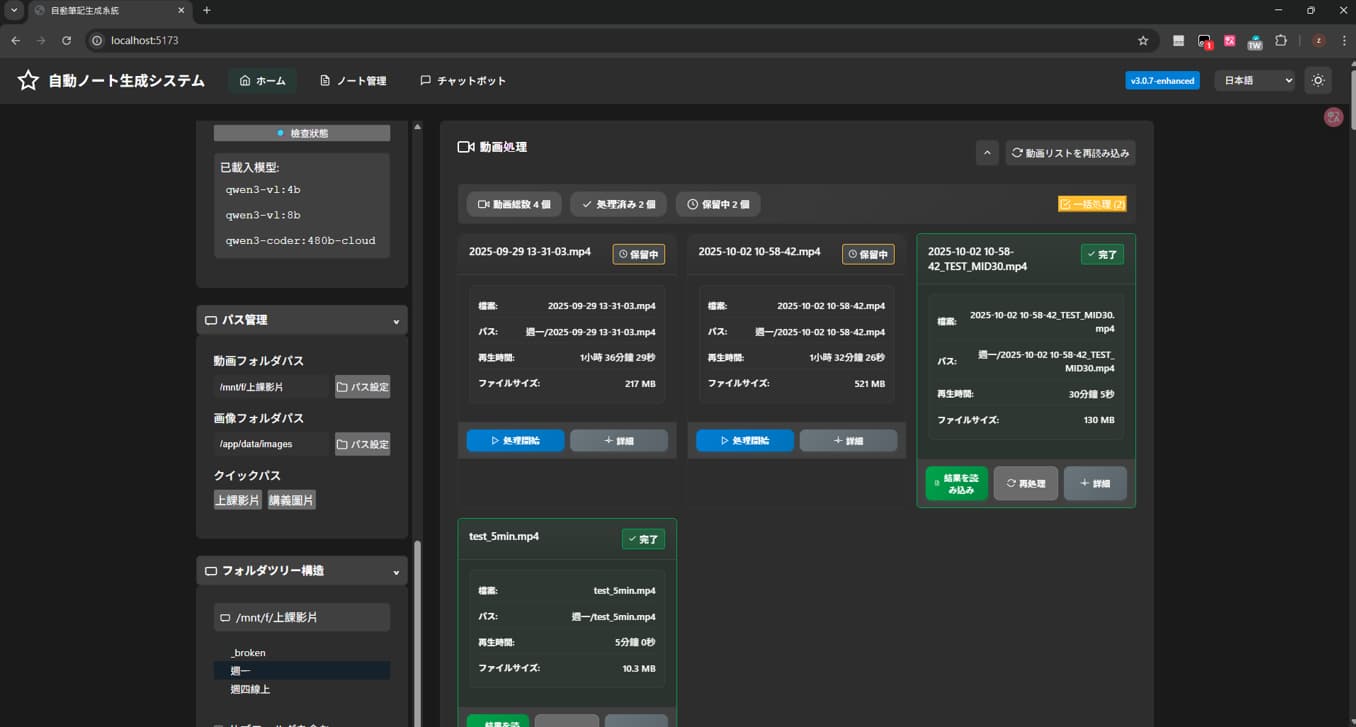
留下的成果
已確認01SUPPORTED
從輸入到結構化筆記的流程
以 Vue 3、FastAPI 與 Docker 接起來。
已確認02SUPPORTED
四個人的分工與整合判斷
切出範圍、選定讀取方向,再在銜接點整合。
已確認03SUPPORTED
畢業專題發表
整理發表投影片與技術報告並完成發表。
已確認
確認狀態
NOTERA / 07以輸入到結構化筆記之間已確認的範圍,以及團隊的判斷為主軸。
章節結論比起畫面,從輸入到筆記的流程才是這次的成果。NOTERA / 07 · RESULT